Cómo medir la productividad del desarrollo con IA
Mi experiencia con agentes de codificación me lleva a medir el cambio validado, la revisión, la estabilidad y el retrabajo, no solo la velocidad.
En mi trabajo con agentes de codificación he perdido más tiempo revisando cambios grandes que parecían terminados que validando una parte pequeña antes de continuar. Es uno de los aprendizajes que cuento al describir mi trabajo con agentes. Esa experiencia me llevó a dejar de confundir código generado o rapidez inicial con productividad. Cuando la mido, relaciono el cambio estable con el esfuerzo que me ha exigido y tengo en cuenta la calidad, el retrabajo y el recorrido completo. El tiempo hasta terminar importa, pero por sí solo mide latencia, no productividad.
No he realizado un experimento comparativo sobre productividad. Al revisar los estudios publicados, he encontrado resultados distintos porque observan tareas, poblaciones y herramientas diferentes. Por eso no convierto mi experiencia ni un porcentaje externo en una predicción para cualquier organización.
Los porcentajes discrepan porque no miden el mismo trabajo
La evidencia de METR, DORA, los experimentos de campo y el estudio de Anthropic sobre aprendizaje no me permite fijar un porcentaje universal de aceleración o ralentización. Cada diseño estudia poblaciones, herramientas, tareas y horizontes distintos.
| Contexto observado | Unidad de trabajo | Resultado publicado | Qué impide generalizarlo |
|---|---|---|---|
| METR, Early-2025 AI Experienced Open-Source Developer Study (10-07-2025): 16 especialistas y 246 tareas reales en proyectos que conocían bien | Tiempo hasta terminar una incidencia | Las tareas tardaron un 19 % más con IA | Muestra pequeña, especialistas y repositorios maduros |
| Cui y otros, The Effects of Generative AI on High-Skilled Work, Management Science: tres experimentos de campo | Tareas completadas por desarrollador | Mejora de productividad con asistentes de código | Procesos, herramientas y definición de tarea propios de cada empresa |
| DORA, State of AI-assisted Software Development 2025: equipos de entrega de múltiples organizaciones | Rendimiento e inestabilidad del sistema de entrega | La IA amplifica capacidades existentes y puede elevar a la vez el rendimiento y la inestabilidad | Relación observada en organizaciones, no causalidad para una tarea concreta |
| Anthropic, AI assistance and coding skills (2026): personas aprendiendo una biblioteca nueva | Tiempo de tarea y dominio posterior | Ligera reducción del tiempo, sin significación estadística y 17 puntos porcentuales menos de dominio (50 % frente a 67 %) | Tarea de aprendizaje acotada, distinta del mantenimiento diario |
| METR, Uplift Update (24-02-2026): herramientas más recientes en proyectos reales | Tiempo de tarea | Señales de mejora, con estimación débil | Quien acepta o rechaza usar IA introduce un sesgo difícil de eliminar |
La tabla reúne trabajos distintos; no intento resolver sus diferencias escogiendo un ganador. En mi experiencia, el tamaño del cambio y cuánto conozco el sistema influyen en el esfuerzo que después me exige revisar e integrar una propuesta. Los estudios añaden otras poblaciones y tareas. La métrica que elijo decide qué parte de ese trabajo queda fuera.
Terminar antes solo demuestra rapidez. Para hablar de productividad hay que medir también defectos, horas de retrabajo y resultados entregados.
Cuando alguien me presenta un porcentaje para decidir una adopción, pregunto quién hizo el trabajo, qué tarea resolvió, cuándo se probó la herramienta y qué significaba «terminado». Sin esas respuestas, el número informa sobre un experimento y muy poco sobre la organización donde se quiere aplicar.
El código generado solo refleja una actividad local
En una herramienta de comprobación de contraste que preparé para mi blog, el resultado automático era 18,25:1 cuando el contraste real era 3,44:1. El cálculo leía los tres primeros valores del color y omitía el canal alfa. Las pruebas que había preparado terminaban correctamente, pero no comprobaban ese caso; Lighthouse detectó el fallo. No uso este episodio como una medida del efecto de la IA. Me sirve para explicar por qué una salida producida o una prueba superada no equivalen a un cambio validado.
Cuando valoro un cambio, todavía tengo que comprobar que encaja en el sistema, respeta los contratos existentes y puede mantenerse. La cantidad de código generado apenas describe ese trabajo.
Contar sugerencias aceptadas tampoco me serviría como medida. Una cifra alta puede reflejar que el asistente resuelve trabajo repetitivo y correcto o que la revisión es superficial. Para interpretarla tengo que mirar qué ocurre después.
Como unidad de análisis tomaría el cambio validado y estable, no el código que apareció primero. Para hablar de productividad lo relacionaría con el resultado que debía producir, el esfuerzo consumido y el coste de calidad. Así puedo mirar más allá de la actividad individual y valorar lo que consigue el sistema de entrega.
La unidad útil es el cambio validado y estable
Considero validado un cambio cuando cumple sus criterios, ha superado la revisión y puede desplegarse con la evidencia acordada. Lo considero estable cuando ha atravesado el periodo fijado para detectar regresiones inmediatas, alertas o retrabajo atribuible a ese cambio.
Fijaría la ventana de estabilidad antes de observar los resultados y la adaptaría a cada familia de trabajo. Podría abarcar, por ejemplo, 72 horas para un servicio con señales continuas o un ciclo completo para un proceso periódico. Marcaría como observación incompleta un cambio que aún no la haya completado; no lo contaría como estable ni lo eliminaría. También conservaría los defectos tardíos como una medida aparte, porque ninguna ventana breve puede capturarlos todos.
El recorrido completo tiene más tramos que la escritura:
requisito entendido
    → cambio propuesto
    → revisión
    → integración
    → despliegue
    → observación
    → cambio estable
La IA puede acortar el segundo tramo y alargar el tercero, o facilitar una prueba y hacer más difícil entender la implementación que la pasa. También puede reducir el tiempo hasta la primera propuesta a costa de más iteraciones antes de integrar. Por eso conservaría esas compensaciones en la medida completa.
No tomaría el despliegue como final automático. Un cambio que entra en producción y provoca una corrección urgente al día siguiente no tiene el mismo valor que otro que permanece estable. Adaptaría la ventana al producto, pero la mantendría fija durante la comparación para que dos cambios de la misma familia sean comparables.
Esta definición tampoco convierte toda contribución en un ticket. El diseño, la investigación, el soporte y la reducción de riesgo tienen otras salidas. La usaría para comparar cambios de software semejantes, que es donde veo que los indicadores de generación suelen utilizarse peor.
La supervisión también consume tiempo y atención
En mi trabajo con IA, parte del esfuerzo se desplaza desde escribir hacia dirigir, evaluar y corregir. Ese trabajo puede ser más valioso que teclear código, pero no es gratuito.
Una petición precisa me exige entender el problema y sus límites; al revisar la respuesta reconstruyo qué hizo el agente, qué omitió y qué supuestos introdujo. Si el resultado falla, decido si lo corrijo, lo devuelvo o cambio de enfoque. Cada ciclo consume atención y contexto que no puedo dedicar a otra tarea.
La carga aumenta cuando el cambio atraviesa muchos módulos o cuando la base de código contiene conocimiento tácito. Aunque el asistente lea miles de líneas, puede seguir sin conocer por qué existe una condición aparentemente redundante. Cuando conozco el repositorio, recuerdo el incidente o la restricción que la explica; si me falta esa historia, también puedo aceptar la simplificación y descubrir el motivo en producción.
Para entender la supervisión, registraría ciclos antes de revisión, tiempo de revisión, cambios solicitados, pruebas añadidas y correcciones posteriores. No mediría el número de mensajes: una conversación corta puede resolver una tarea simple o esconder una revisión pobre.
Medidas para no premiar actividad
Propondría siete medidas juntas porque ninguna basta de forma aislada. Las usaría para entender el trabajo, no para contar líneas ni clasificar personas.
| Medida | Definición operativa | Dato observable | Lectura equivocada que evita |
|---|---|---|---|
| Tiempo de flujo hasta cambio estable | Desde que el trabajo entra en una cola acordada hasta que supera la ventana de estabilidad | Marcas del gestor de trabajo, revisión, despliegue e incidencias | Confundir primera propuesta con finalización o esconder esperas |
| Esfuerzo activo | Tiempo humano dedicado a entender, producir, revisar, corregir y recuperar | Registro ligero por tarea o muestreo acordado | Reducir calendario añadiendo capacidad y llamarlo productividad |
| Carga de revisión | Atención necesaria para comprender y aceptar el cambio | Tiempo de revisión, ciclos, comentarios sustanciales y pruebas añadidas | Considerar gratuita la supervisión |
| Estabilidad, riesgo y retrabajo | Trabajo posterior atribuible al cambio, con severidad y exposición | Reversiones, correcciones, incidentes, tiempo de recuperación y defectos tardíos | Tratar igual una errata y una brecha o premiar entregas que trasladan el coste |
| Comprensión para mantener | Otra persona puede explicar y modificar el mecanismo | Revisión explicada, tarea de cambio posterior o prueba de comprensión | Aceptar código que solo entiende quien dirigió al agente |
| Flujo entregado | Cambios estables por familia durante una ventana, junto con el trabajo en curso | Conteo de resultados comparables y trabajo en curso | Mejorar la latencia seleccionando solo tareas fáciles o acumulando trabajo |
| Resultado o valor | Cambio observable asociado al objetivo acordado antes del trabajo | Métrica de producto o de resultado definida de antemano | Entregar muchos cambios correctos que no resuelven un problema importante |
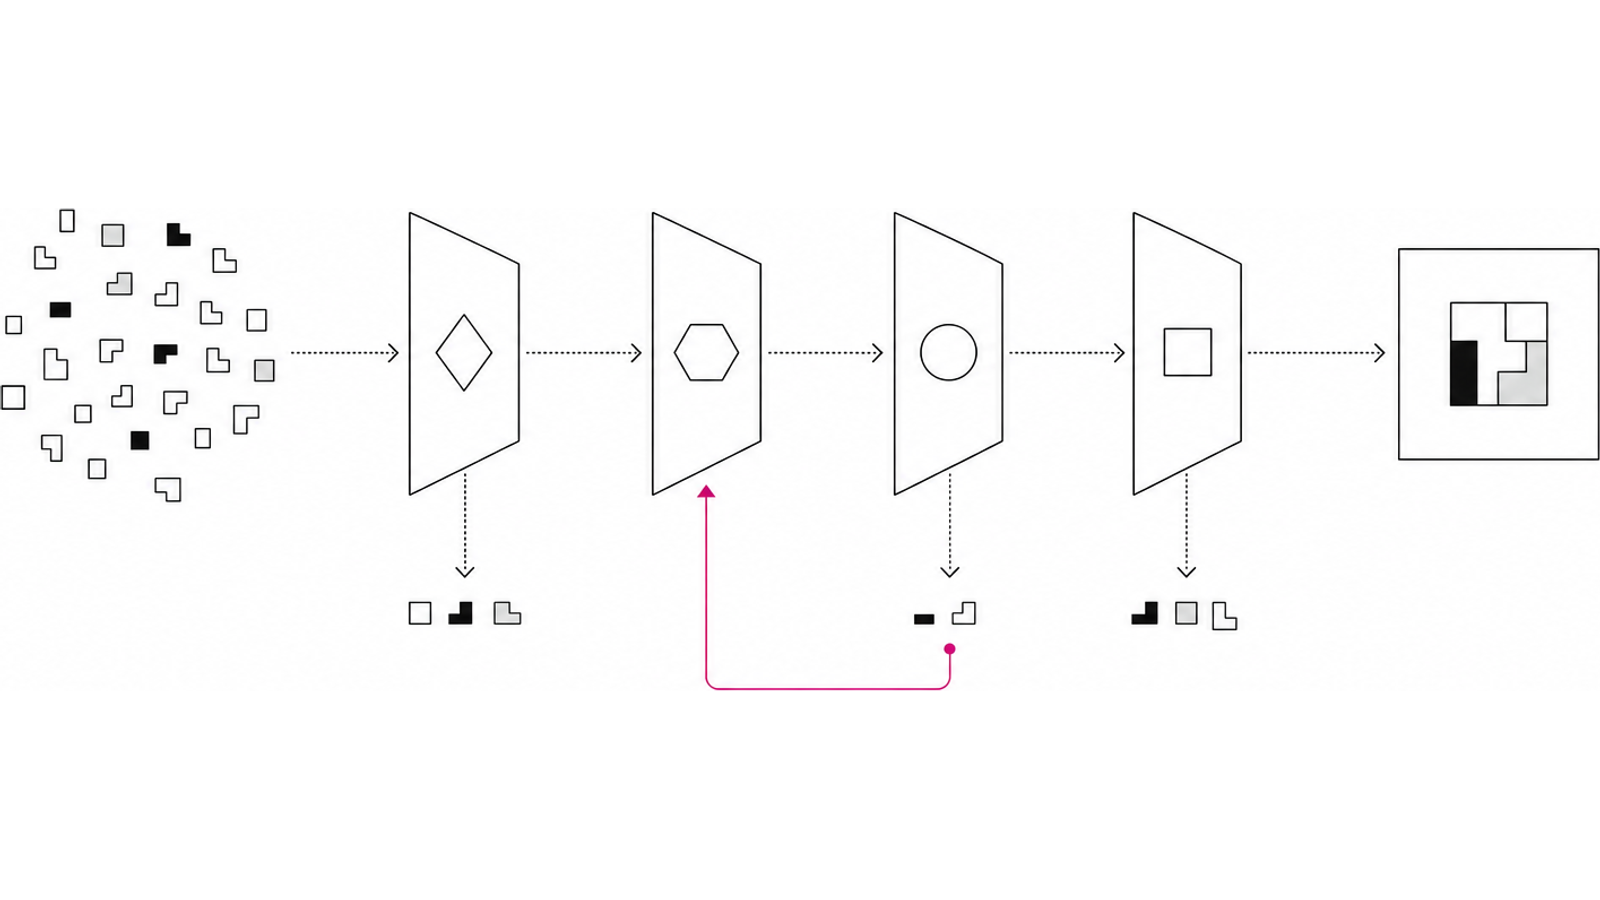
No agregaría las medidas en una puntuación. Una cifra única oculta la razón de la mejora. Si baja el tiempo y sube mucho el retrabajo, quien toma la decisión necesita ver ambos movimientos. Si aumenta la revisión y disminuyen las incidencias, puede haber una inversión razonable en calidad.
La comprensión es la medida menos cómoda y una de las más importantes, pero no requiere exámenes. Yo la comprobaría durante la revisión: quien mantiene el cambio explica el flujo, localiza los invariantes y propone cómo modificaría un caso relacionado. Si nadie puede hacerlo, la velocidad local ha creado una dependencia.
Cuándo cabe esperar una mejora y cuándo no
Mi hipótesis de partida es que la IA tiene más margen en tareas acotadas cuyo resultado puede comprobarse enseguida y que tienen criterios verificables. Migraciones mecánicas, generación de pruebas a partir de contratos claros, adaptadores repetitivos y cambios dentro de patrones bien establecidos permiten comprobar pronto si el resultado encaja.
El margen disminuye cuando el trabajo consiste en descubrir el problema, recuperar conocimiento tácito o decidir una arquitectura, y también en bases maduras donde una modificación pequeña puede romper contratos que no están documentados. En esos casos el agente produce una propuesta antes, pero la revisión concentra el coste.
Al valorar una tarea, separaría la entrega puntual del aprendizaje. Delegar la exploración puede ahorrar tiempo cuando importa terminarla; si también quiero que alguien domine una biblioteca o un dominio, aceptar una solución antes de construir el modelo mental puede perjudicar la tarea siguiente. Acordaría cuál de esos objetivos tiene prioridad antes de medir.
En mi trabajo, una especificación útil mejora las condiciones porque reduce supuestos y hace observables los criterios. No sustituye la comprensión ni la decisión de arquitectura.
Un piloto observacional de cuatro semanas
Propondría un piloto observacional de cuatro semanas para calibrar las medidas y aprender dónde encaja la IA. No lo usaría para atribuirle causalidad ni evaluar a cada desarrollador. Si una familia no reúne suficientes casos o no cubre su ciclo normal, ampliaría la ventana antes de decidir.
En la primera semana elegiría dos o tres familias comparables. Las distinguiría por tipo y tamaño del cambio, riesgo, módulos afectados y familiaridad con el código. También fijaría la ventana de estabilidad, el inicio y el final de cada medida y cómo atribuir el retrabajo. Dejaría escritos los criterios de inclusión y exclusión y publicaría cuántos casos quedan fuera y por qué. Una incidencia causada por el cambio nunca saldría de la muestra.
Durante las semanas segunda y tercera dejaría que cada persona decidiera en qué tareas usar la IA y anotaría esa decisión antes de empezar. Registraría las siete medidas junto con la familia, el riesgo, el tamaño, la familiaridad, la herramienta, el modelo, la versión, el tipo de uso, el coste, el tiempo activo y el motivo para usar o no IA. Esa autoselección se parece más al trabajo cotidiano, pero me impediría afirmar que la IA causó la diferencia.
Agregaría los datos por grupos con un mínimo de casos que evite identificar a una persona, acceso limitado y retención corta. No los usaría para clasificar individuos. Antes de empezar fijaría también qué código o datos no pueden enviarse a una herramienta, cómo proteger secretos y cómo revisar licencias, dependencias y vulnerabilidades.
En la cuarta semana revisaría casos, no solo promedios. ¿Dónde bajó el tiempo completo? ¿Qué cambios exigieron más revisión? ¿Apareció retrabajo? ¿La persona que mantuvo después el código pudo explicarlo? Compararía familias de tareas y conservaría las excepciones que contradijeran la tendencia.
Cuatro semanas no demuestran causalidad ni suelen ofrecer base para una inferencia estadística. Sí me servirían para detectar una medida inútil, una familia prometedora o un coste que habría pasado por alto. Si quisiera responder una pregunta causal, propondría otro diseño: asignación aleatoria, implantación por fases o tareas emparejadas con controles previos.
Con los resultados propondría una política acotada: usar la IA para transformaciones mecánicas y pruebas, exigir revisión adicional en interfaces públicas y reservar las tareas de aprendizaje para un modo en el que la herramienta formule preguntas, explique opciones y pida a la persona anticipar el siguiente paso antes de proponer la solución.
La decisión no sale de un umbral universal, pero tampoco la improvisaría después de ver los datos. Antes del piloto acordaría qué mejora considero material y qué degradación de riesgo, retrabajo o comprensión sería inaceptable. Ampliaría el uso cuando mejorase el resultado o el flujo sin aumentar el esfuerzo total ni empeorar la revisión, los incidentes o la comprensión. Lo mantendría acotado cuando el ahorro solo apareciera en familias concretas o exigiera una supervisión asumible. Lo detendría si el retrabajo, el riesgo o la pérdida de comprensión compensaran el tiempo ahorrado.
La decisión se revisa cuando cambia la herramienta o el trabajo
Una medición fechada describe una combinación concreta de personas, base de código, herramientas y tareas. Si cambia el modelo, el flujo de revisión o el tipo de trabajo, la conclusión puede dejar de servirme.
Mantendría un conjunto pequeño de indicadores y revisaría la decisión cada trimestre. Buscaría dónde aumenta el rendimiento y dónde se traslada trabajo a la revisión, la estabilización o el mantenimiento, en vez de usar los datos para justificar retrospectivamente la inversión.
La misma regla se aplica a la automatización fuera del desarrollo. El ahorro se calcula después de comprobar el resultado e incluir excepciones. La pieza sobre cómo verificar una automatización de IA desarrolla ese contrato.
Medir bien cambia la conversación. Con estas medidas propondría dejar de discutir solo si «la IA va más rápido» y decidir en qué tareas entrega cambios mejores con un coste total menor. Esa es la productividad que yo intentaría optimizar.
Más de 22 años construyendo y evolucionando plataformas de aprendizaje en producción.
Sobre Alberto Lara y su trayectoria profesional →Seguir leyendo
- Qué hacía antes un desarrollador y qué tiene que hacer ahora con agentes de IA
Cuento qué ha cambiado en mi trabajo con agentes de IA: el análisis, el contexto que preparo, la revisión del código y mi responsabilidad sobre el resultado.
- Si un prompt puede provocar un fallo en producción, necesita ingeniería
La IA puede escribir más código por nosotros, pero también nos obliga a diseñar, versionar, probar, asegurar y mantener una nueva capa de software alrededor de los agentes.
- Lo que he aprendido trabajando con agentes en desarrollo de software
Dieciséis meses con agentes aplicados al desarrollo de software en repositorios reales. Los errores que he cometido, lo que me ha funcionado y cómo trabajo ahora.